Gmeek 折腾实录|一次给博客加功能的完整实操:从选型、本地实测、中文支持到 Actions 全自动。这篇不占番外编号——番外四讲过借浏览器截图,番外五讲过 Skill,这次是真刀真枪给博客补上「搜索」这个缺了很久的功能。
一、小白问题:72 个页面,想找一句话怎么办
叶扬的博客写到现在,站上已经有 72 个页面,其中 62 篇是正文。想找之前写过的某个说法,怎么办?
浏览器里 Ctrl+F 只能搜当前打开的这一页;标签页(/tag.html)能按标签过滤,可标签是粗粒度的——「我记得有篇文章里提过某个词,但想不起是哪篇、也不知道归在哪个标签下」,这两个工具都帮不上忙。这其实就是全文搜索的需求。
常规的三条路:
| 方案 | 代价 |
|---|---|
| SaaS 搜索(Algolia 一类) | 要注册账号、管 API Key,多数有额度门槛,DocSearch 类还有项目资格要求 |
| 自建搜索后端 | 为一个搜索功能养一台服务器,违背静态站的初衷(B06 讲过 Pages 的边界) |
| Pagefind | 构建时在本地离线建好索引,产物是纯静态文件;访客查询时,搜索引擎(WASM)在访客自己浏览器里运行 |
Pagefind 的思路可以这么理解:普通搜索引擎是「网站把数据发给服务器,查询时服务器现搜」;Pagefind 反过来——构建期就把整站预编译成一份搜索索引,连同一个微型搜索引擎一起发给访客。没有服务器,没有 Key,没有额度。
二、一条命令:72 页、3 秒、2 MB
Pagefind 由 CloudCannon 团队的 Liam Bigelow 发起,现在已独立为 Pagefind 项目。截至本文最新版 v1.5.2,GitHub 上 5000+ star,发版活跃。它是个 npm 包,不用装进项目依赖,npx 直接跑:
npx -y pagefind@1.5.2 --site docs --output-subdir pagefind--site docs 指定静态站点目录(Gmeek 生成的 HTML 都在 docs/),--output-subdir pagefind 指定索引输出到 docs/pagefind/。跑完的输出:
[Reading languages]
Discovered 1 language: zh-cn
[Building search indexes]
  Indexed 72 pages
  Indexed 14847 words
Finished in 2.988 seconds
72 个页面、14847 个索引词、不到 3 秒。再看产物:
docs/pagefind/
├── fragment/            # 每个页面的正文片段(懒加载,搜中才下载)
├── index/               # 索引主体(分片,查哪个词下哪片)
├── pagefind-ui.js/.css  # 现成的搜索界面(可选,也可以只用底层 API)
├── pagefind.js          # 底层搜索 API
├── pagefind-worker.js   # v1.5 起搜索跑在 Web Worker 里
└── wasm.*.pagefind      # WebAssembly 搜索引擎
整个目录 2.0 MB。注意这 2 MB 不是访客每次搜索都要全量下载——索引是分片的,输入查询时才下载相关的分片;2 MB 是全站索引的总上限。
输出里还有两行提示值得解释:
1 page found without an <html> element ... "/google1e7515c0f1de4bc9.html"
这是 Google 站长平台的验证码文件,本来就不是给人看的页面,跳过它完全正确(这种验证文件还必须永久留在站上,不能删)。
Note: Pagefind doesn't support stemming for the language zh-cn.
Stemming(词干提取)是英文这类语言需要的——把 running / runs / ran 归到同一个词根。中文根本没有词形变化,这条警告对中文无实际影响。
三、中文实测:分词是个真问题,Pagefind 交了卷
静态搜索工具挑中文博客,最大的坎是分词。英文天然靠空格分词,中文一句话是连写的——「阿赖耶识」四个字,是一个词、两个词还是四个词?索引时分错了,搜索就搜不中。
Pagefind 的解法分两半(这是查了官方 CHANGELOG 核实过的,不是猜的):
- 索引侧:
npx pagefind默认拉的是 extended(扩展)二进制,内置中文、日文分词词典,建索引时按词典把整句切成词。如果去 GitHub Releases 手动下载二进制,会看到标准版和扩展版两个附件——做中文站必须选扩展版,标准版不含中日分词。 - 查询侧:v1.5.0 起,搜索框里直接粘贴一整句中文也能搜——Pagefind 在浏览器里调用
Intl.Segmenter(现代浏览器内置的分词 API)把查询切开。CHANGELOG 里的例子:搜「这是一段简单的测试文本」,实际按「这 / 是 / 一段 / 简单 / 的 / 测试 / 文本」检索,和索引时的切法一致。
说法归说法,叶扬在本地起了 Pagefind 自带的测试服务,用真实索引跑了一轮,用的是浏览器端 JS API(不是截图看效果,是真调接口数结果):
| 查询 | 命中页面数 |
|---|---|
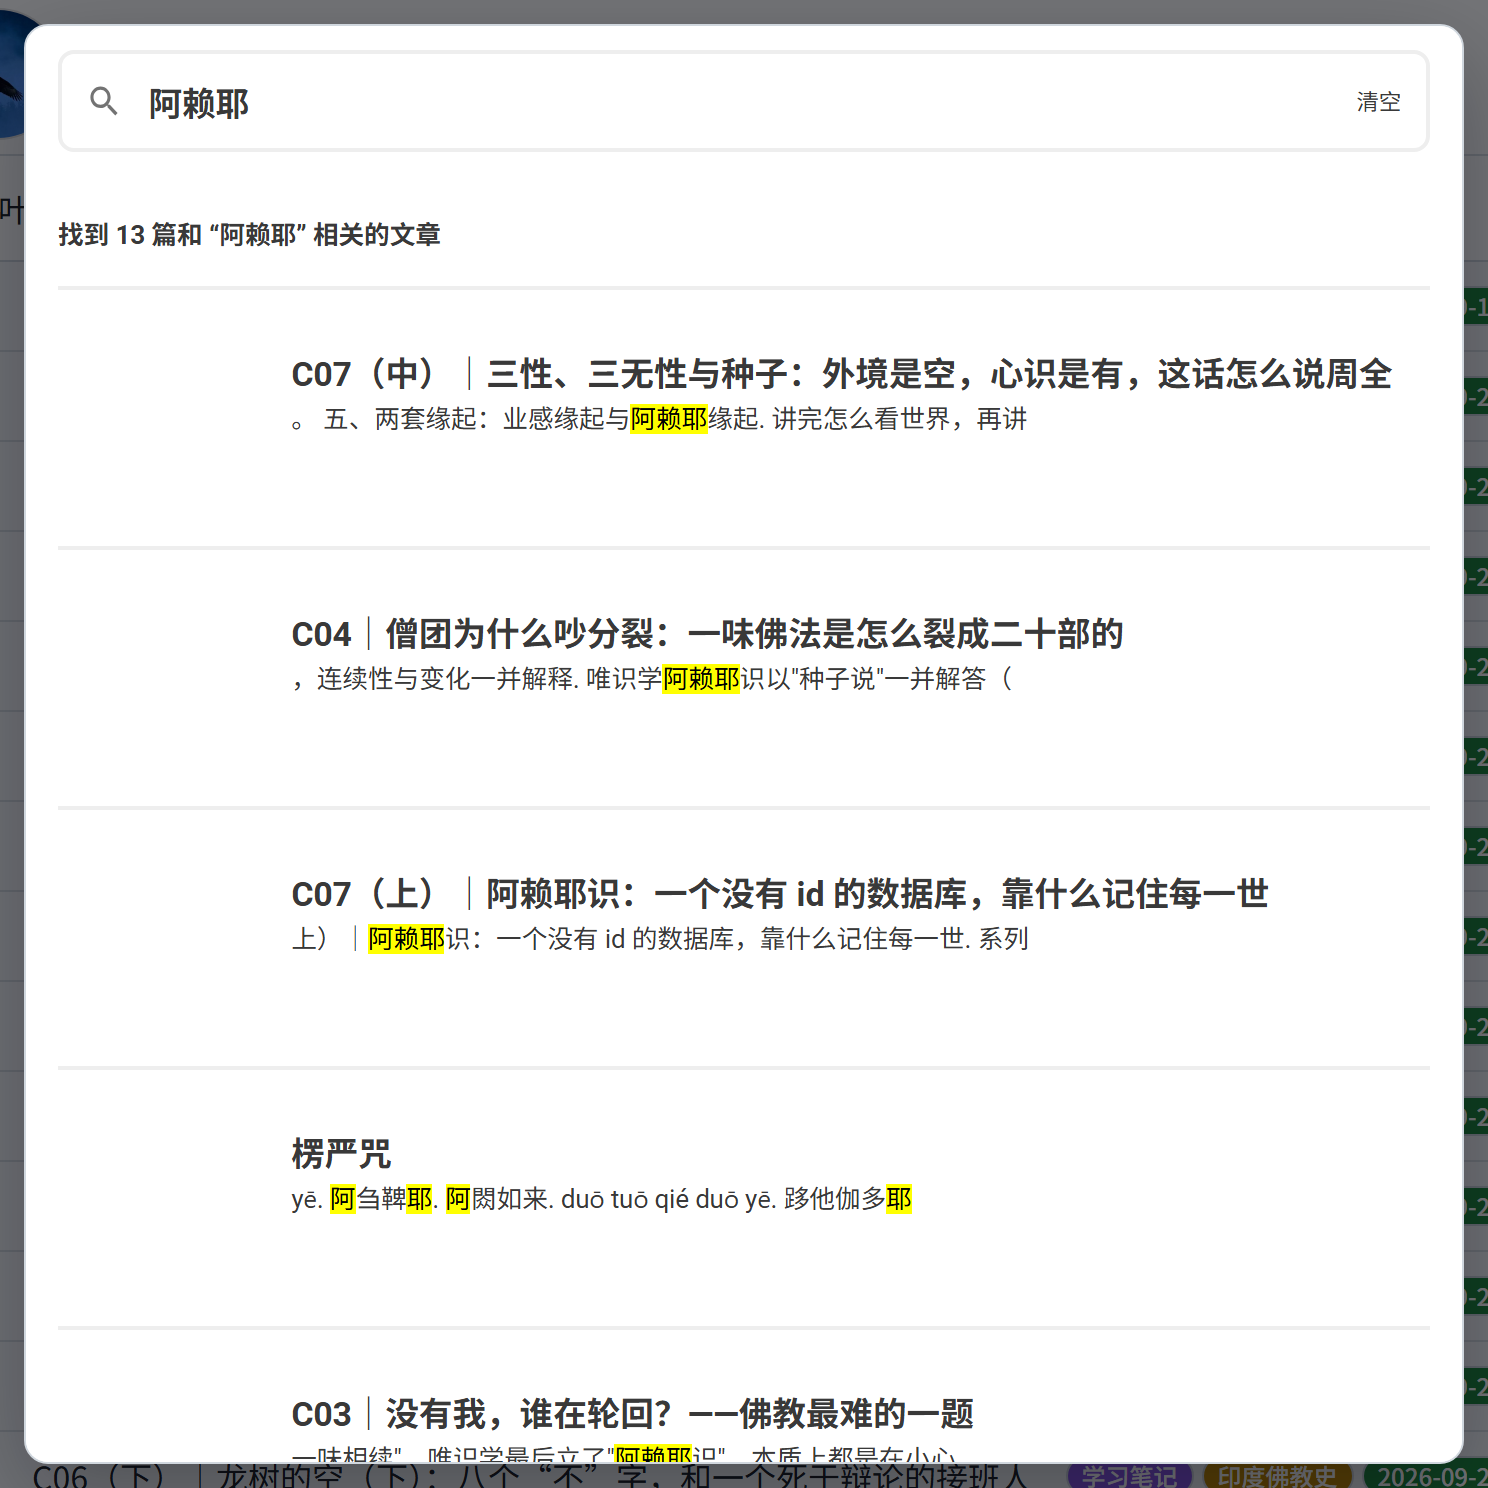
| 阿赖耶 | 13 |
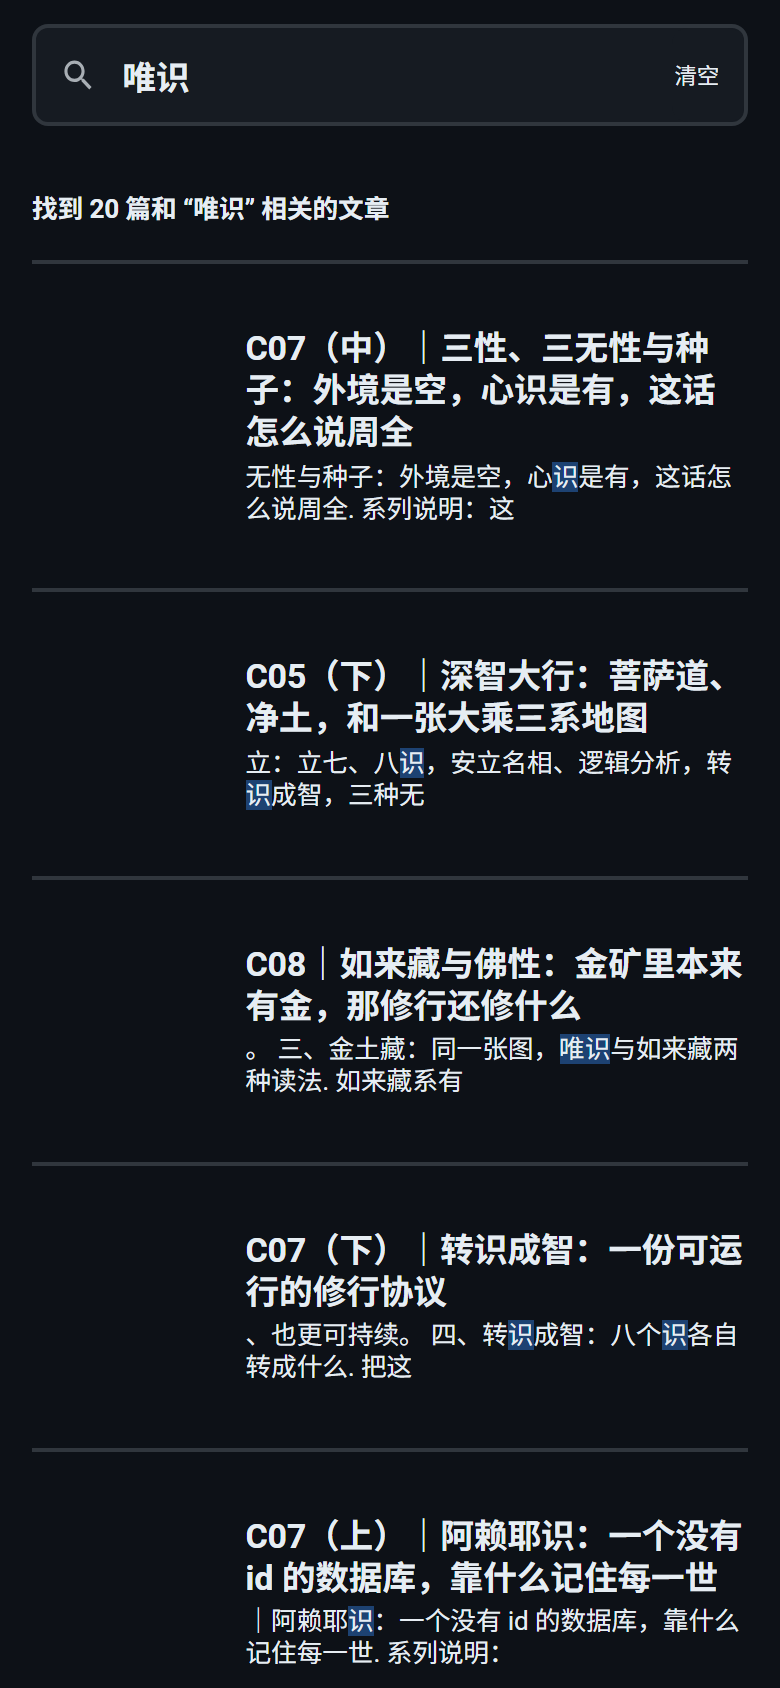
| 唯识 | 20 |
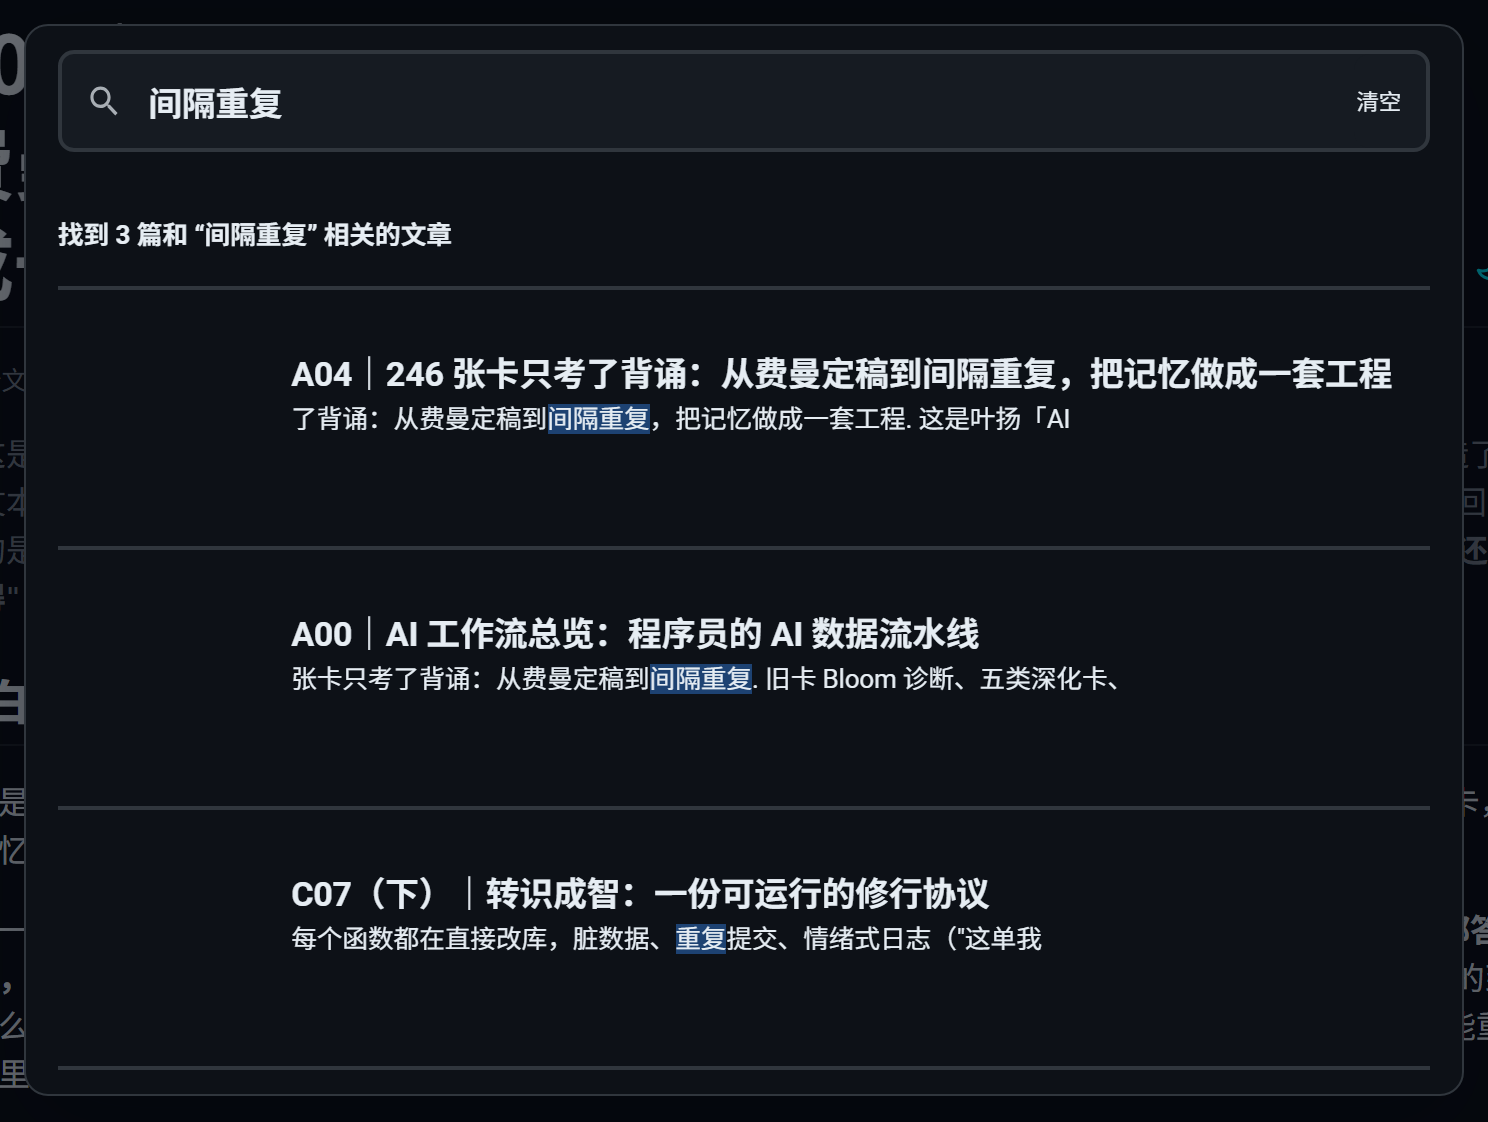
| 间隔重复 | 3 |
| 本有新熏 | 4 |
| 斯陀含 | 9 |
| 空(单字) | 47 |
| 阿赖(两字片段) | 14 |
专有名词、长短语、单字都能命中。这里有个有意思的细节:搜「阿赖」有 14 条,比搜「阿赖耶」的 13 条还多——因为查询被切成更细的单位后,命中的是「包含这两个字」的页面,不要求连在一起。这是召回更宽的表现,算不算「更准」取决于场景,但至少证明中文用户不用再自己拿空格把查询切开。
四、接进 Actions:每次构建自动重跑,一次配好永久生效
本地验证通过,接下来是让索引在云端自动维护。Gmeek 的构建流程(B00 拆过)是:Actions 里 clone 上游源码 → 跑 Gmeek.py 生成 HTML 到 docs/ → 生成 sitemap、拼 README → commit 回仓库 → 打包 docs/ 部署到 Pages。
Pagefind 的索引必须在 HTML 生成之后、部署之前插入,在 workflow 里加一个步骤:
      - name: Pagefind index
        run: npx -y pagefind@1.5.2 --site docs --output-subdir pagefind
版本号写死(1.5.2),不写 @latest——构建工具要可复现,哪天 Pagefind 大改版,至少不会让博客的自动构建莫名其妙挂掉。
位置上有个讲究:这一步放在 commit 之前,于是 docs/pagefind/ 会像 sitemap、README 一样被 Actions 提交回仓库;同时它在打包部署之前,产物也会随 Pages 发出去。每次发文章 HTML 都重新生成,索引自然也要每次重跑——72 页只要 3 秒,成本可以忽略。
五、搜索入口:复用旧按钮、明暗两套配色
光有索引还不够,得让读者在每个页面都能点开搜索框。Gmeek 的页面结构不能直接改模板(每次构建都从上游 clone,改了会被覆盖),老办法:写一个前端插件,在浏览器里动态装配。插件 GmeekPagefind.js 做了这几件事:
- **列表页(首页)**本来就有一个搜索图标(旧版链接到标签页)——直接劫持这个按钮,图标不变,点击改为打开 Pagefind 弹窗,不新增多余按钮;
- 文章页、固定页、标签页没有 Pagefind 入口(标签页自带的是按标签过滤的旧搜索框,两回事),就在右上角按钮组里注入同款圆形搜索按钮;
- Pagefind 的界面 CSS/JS 首次点击时才加载(懒加载),不增加日常页面体积;
- 键盘党友好:按
/唤起搜索,按Esc关闭; - 手机端搜索面板自动铺满全屏。
弹窗用的是 Pagefind 自带 UI,但它默认是浅色变量。博客有明暗三态主题(B08 做的),暗色适配靠覆写它暴露的 CSS 变量,照 GitHub Dark 的色板来:
[data-color-mode="dark"] .pagefind-ui {
    --pagefind-ui-text: #e6edf3;
    --pagefind-ui-background: #161b22;
    --pagefind-ui-border: #30363d;
    --pagefind-ui-primary: #58a6ff;
    --pagefind-ui-tag: #21262d;
}
[data-color-mode="dark"] .pagefind-ui mark {
    background: rgba(56,139,253,.4);
    color: #e6edf3;
}
界面文案也通过参数换成中文(「搜索文章…」「正在搜索…」「找到 13 篇和 "阿赖耶" 相关的文章」「找不到和 xxx 相关的文章」)。这里有个细节值得一说:官方自带的中文翻译文件其实已经覆盖了全部 26 个界面状态,直接引用就不会出现「界面一半中文一半英文」——只有想自定义措辞时才逐项覆写。另外摘要长度默认偏短、中文片段容易切碎,调 excerptLength: 22 后读起来正常多了。
六、坑清单:自己踩的,和留给上游的
本地测试别只拷插件文件。 叶扬第一次在本地验证时,把插件 JS 拷进了 docs/plugins/,点击搜索按钮后页面直接跳走了。排查发现:docs/ 里的 HTML 是改配置之前生成的,<head> 里根本没有插件的引用标签——文件在,但没有任何页面加载它。docs/ 是构建产物,本地改它不算数,要从源头(config.json 的 allHead 字段)改完重新生成。这跟 B00 讲的「改东西要找到真源」是同一个道理。
无头浏览器验收照旧本地注入 primer CSS。 老坑:headless 环境拉不到 Primer 镜像,不加本地 CSS 拦截,整页透明白底。截图是最后一道防线,配图三张全部实拍过,图面零错字。
索引范围暂时是整页。 目前没有配置 data-pagefind-body 属性,Pagefind 索引的是整个 <body>——页头的导航、页脚的文字也会进索引,搜「首页」可能命中所有页面。精确圈定正文区域需要在生成的 HTML 上加标记,这要动 Gmeek 模板,适合给上游提 PR,目前整页索引的噪音对实际使用影响不大。
列表页本身也会成为搜索结果。 首页和翻页(index.html / page2.html …)都是完整 HTML,自然也被索引,搜宽词时结果里会混入列表页。v1.5.2 的命令行没有单独的页面排除参数(只能换文件匹配 glob),为一个小噪音改 glob 不划算;真介意的话,后续配合正文标记一起处理。
搜索弹窗本身也补了基础无障碍。 打开时锁住背景滚动,Esc 关闭后焦点还给刚才点的按钮;慢网或加载失败时会有明确提示,不会点了按钮毫无反应。
收尾:一笔成本账
| 项目 | 数字 |
|---|---|
| 索引全站耗时 | 约 3 秒 |
| 索引总体积 | 2.0 MB(分片懒加载) |
| 新增服务器 | 0 |
| API Key / 账号 | 0 |
| 后续维护 | 每次发文章自动重建 |
搜索框现在就挂在每个页面的右上角,或者按一下 /,随时可用。
这是「GitHub 好项目实操」系列的第一篇。下一篇已经排上:终端操作演示的升级——用脚本化的方式生成终端录屏,让命令行教程不再只有静态截图。
术语表
- Pagefind:静态站点的零后端搜索工具;构建期建索引,查询在访客浏览器里完成
- 索引(index):把正文切成词、记录每个词出现在哪些页面的检索数据结构;相当于给全站内容建一份「倒排目录」
- Stemming(词干提取):把同一词的不同形态归并(英文 run/runs/running);中文无词形变化,用不上
- 分词(segmentation):把连写的中文句子切成词;Pagefind 扩展版索引侧带词典,v1.5 查询侧用浏览器
Intl.Segmenter - WASM(WebAssembly):可以在浏览器里高速运行的二进制代码,Pagefind 的搜索引擎就编译成 WASM
- Web Worker:浏览器的后台线程;Pagefind v1.5 起搜索在 Worker 里跑,打字时页面不卡