这是叶扬「AI 工作流」系列第五篇。前四篇都在处理课程素材:A01 清洗篇 把四万八千行脏文本洗干净,A02 下载篇 逐集取回字幕,A03 补档篇 给缺字轨的课程造文本,A04 记忆卡片篇 让干净文本真正进脑子。这一篇换个方向——素材变成文章、文章发在博客上之后,怎么让站外平台的读者也看到。叶扬挑了最难自动化、也最值得自动化的知乎,目标只有一句话:脚本把一切准备好存进草稿箱,人只做最后一步。
小白问题:写个脚本把 Markdown 往知乎编辑器里一塞,十分钟收工?
博客攒到七十多篇的时候,叶扬开始认真琢磨分发这件事。知乎是首选:长文友好、技术话题有人看。
乍一听这事毫无难度:本地有 Markdown 源稿,知乎写文章页有个大输入框,写个脚本把内容塞进去,再模拟点一下「发布」——收工。手工发的话,复制粘贴加修格式,一篇文章折腾二十分钟,七十多篇就是整整两天的体力活。
真动手,叶扬发现知乎编辑器是块硬骨头:
- 正文不是普通的
<textarea>,是 Draft.js(Meta 开源的富文本编辑器框架),编辑器的内容活在 JS 状态里,直接往 DOM 上写文本,状态不认; - 粘贴 Markdown 之后,页面弹一个浮条问要不要「确认并解析」,浮条一秒上下就自动消失,点晚了内容就以一堆
##、![]()的原样躺平; - 好不容易填好、想删掉自动保存产生的重复草稿时,删除按钮点了没反应——这一问最后查出一个连排查方向都想不到的根因。
这篇文章就按踩坑的先后顺序讲:怎么跟浏览器接线、怎么骗过 Draft.js、怎么抢那个浮条、以及那场"删除按钮失灵"的血案。代码是真跑通的,数字是当场核的。
一、先画线:脚本到草稿箱为止,发布按钮永远人来点
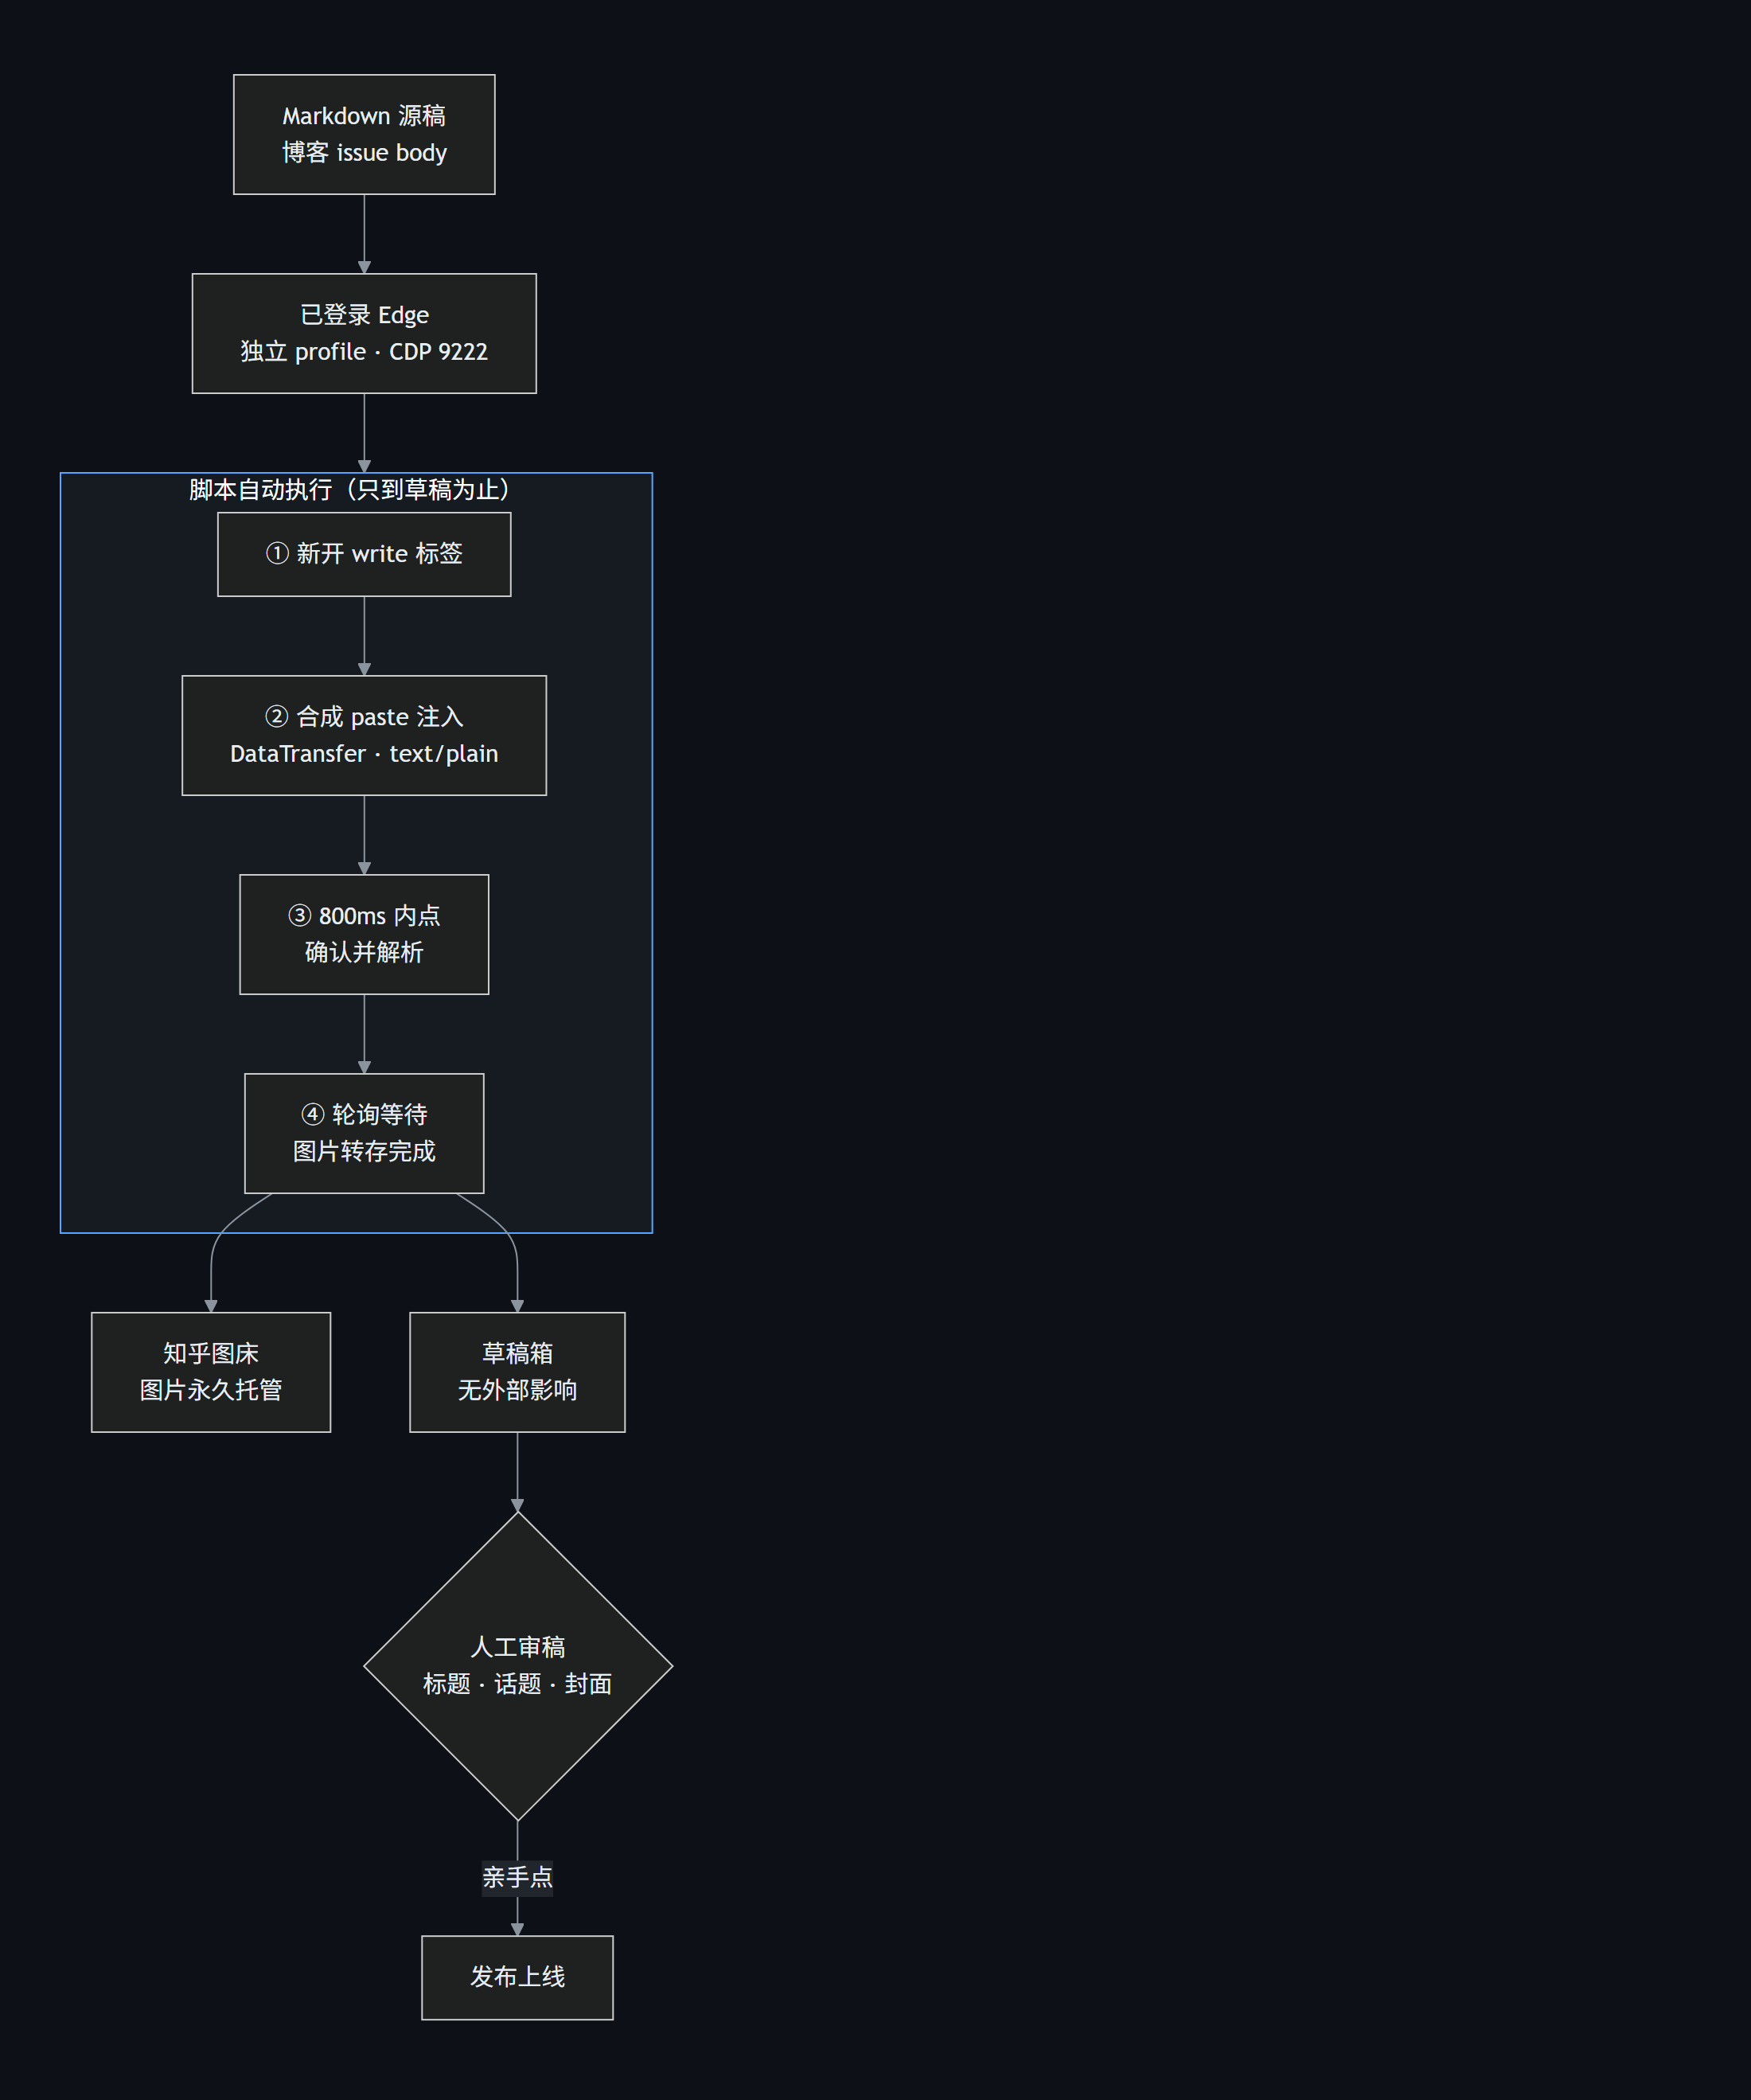
动手之前先定边界,这条边界决定了后面所有技术选型:
脚本只负责把内容填进草稿箱,「发布」按钮永远由叶扬本人点。
理由有三条,每一条都很实在:
- 发布不可逆。文章一旦发出去就进了知乎的时间线、搜索索引和关注者的通知里,删了也留痕。草稿没有任何外部影响,存坏了删掉重来就是;
- 发布前的判断无法脚本化。标题要不要再改、话题挂哪几个、封面用哪张、有没有哪句话发出去不妥——这些都值得活人在点按钮之前过一遍;
- 风控。一个账号突然由脚本高频发文章,是平台风控最典型的异常画像。而"脚本填草稿、人审后发布",从知乎服务器看到的行为序列是:正常粘贴、自动保存草稿、人手动点发布——和真人的操作一模一样。
配套措施是给自动化单独准备一个 Edge profile(用户配置目录),在里面登录一次知乎,之后长期复用。脚本从不接触密码,登录态由浏览器自己保管;这个 profile 也跟叶扬日常浏览用的 profile 完全隔离,自动化脚本只能看到自己那摊东西。
二、请出浏览器真身:CDP 9222 的四个接口
要让浏览器听脚本指挥,得先以远程调试模式启动 Edge:
msedge.exe --remote-debugging-port=9222 --user-data-dir="C:\...\edge-profile"--remote-debugging-port 一开,Edge 就在本机 9222 端口提供一套 HTTP + WebSocket 接口,这套协议叫 CDP(Chrome DevTools Protocol),Chrome 和 Edge 通用。脚本通过它能让浏览器执行任意 JS、截图、甚至派发"物理级"的鼠标键盘事件。
工具脚本 zhihu-draft.js 只用到四个 HTTP 接口,都很朴素:
| 接口 | 作用 |
|---|---|
GET /json/version |
确认调试端口在线、浏览器版本 |
GET /json/list |
列出当前所有标签页,每个标签带一个 WebSocket 地址 |
PUT /json/new?<url> |
新开标签页 |
GET /json/close/<id> |
关闭标签页 |
这里有两个不大不小的坑,都属于"文档没强调、踩了才知道":
- 开标签必须用 PUT。新版浏览器对
/json/new的 GET 请求只回一句 "Using unsafe HTTP verb GET to invoke /json/new. Use PUT instead.",标签根本不开; - 关标签的返回不是 JSON。
/json/close/*成功时回的是纯文本Target is closing,脚本若按 JSON 解析直接报错——工具里为此单独写了一个getText(),跟返回 JSON 的接口区别对待。
拿到标签页的 WebSocket 地址后,后续的好戏都在这条长连接上:发 Runtime.evaluate 让页面执行 JS,发 Page.captureScreenshot 截图。Node.js 较新版本自带全局 WebSocket,连依赖都不用装。
整条自动化的骨架先看一张总图:脚本活动范围严格止于草稿,发布那一步有一道“人工审批门”:
三、第一回合:编辑器找到了,内容塞不进去
第一步是"侦察"。新开知乎的写文章页(zhuanlan.zhihu.com/write),让浏览器执行一段 JS 摸清结构:
- 标题框:一个普通的
<textarea>,placeholder 写着「请输入标题(最多 100 个字)」; - 正文框:一个
contenteditable的div,class 里带着public-DraftEditor-content——Draft.js 编辑器的标志性类名。
叶扬先拿标题框试手。最直觉的写法是 textarea.value = '标题',结果页面毫无反应。原因是现代前端框架给表单元素挂了自己的事件监听,直接改 value 属性不会触发框架内部的状态更新——值确实写进 DOM 了,但框架"不知道"。
标准解法是模拟真人输入的完整事件序列:用原生 setter 写值,再派发一个 input 事件:
const ta = document.querySelector('textarea');
ta.focus();
const setter = Object.getOwnPropertyDescriptor(
    window.HTMLTextAreaElement.prototype, 'value').set;
setter.call(ta, '一个 CLI 统管七十多种存储:rclone 备份同步完整实操');
ta.dispatchEvent(new Event('input', { bubbles: true }));
标题这一关过了。正文才是真正的 Boss——对一个 Draft.js 编辑器,innerText = '...' 这种写法连 DOM 这一层都站不住,光标一点就现原形。要让 Draft.js 老老实实接收一大段富文本,得用编辑器唯一无条件信任的输入通道:粘贴。
四、第二回合:合成一次"以假乱真"的粘贴
人在网页上按 Ctrl+V 的时候,浏览器会往页面派发一个 paste 事件,事件里挂着一个 clipboardData 对象,里面是剪贴板内容(纯文本、HTML、图片……)。富文本编辑器监听这个事件、读取内容、写进自己的状态。
脚本要做的,就是把这个事件合成出来。难点有两个:
paste事件的clipboardData是只读的,构造时塞不进去;- 得真有一个地方放剪贴板内容——浏览器提供了
DataTransfer对象(拖拽和剪贴板共用的数据容器)。
组合起来,先把 Markdown 全文放进 DataTransfer 的 text/plain,再创建 ClipboardEvent,用 Object.defineProperty 把 clipboardData 强行挂上去:
const editor = document.querySelector('[contenteditable=true]');
editor.focus();
const dt = new DataTransfer();
dt.setData('text/plain', markdown全文);
const ev = new ClipboardEvent('paste', { bubbles: true, cancelable: true });
// clipboardData 只读,靠 defineProperty 把 DataTransfer 塞进去
Object.defineProperty(ev, 'clipboardData', { value: dt });
editor.dispatchEvent(ev);
事件一派发,Draft.js 的粘贴处理流程就被完整触发了——和叶扬本人按 Ctrl+V 走的是同一套代码路径。
这里有个一度让人犹豫的岔路口:粘贴内容其实可以同时带 text/html,即把 Markdown 预先渲染成 HTML 再贴,这样排版一步到位。实测结论是不能用:text/html 贴进去格式确实漂亮,但 Draft.js 的 HTML 导入逻辑会把外链图片全部丢弃(出于安全,不允许从粘贴内容里直接引入第三方图片地址)。而只带 text/plain 让知乎自己解析 Markdown,文中的  会被知乎服务器主动抓取、转存到知乎自己的图床——这才是想要的效果:图片永久托管在平台侧,不依赖任何外链。
五、800 毫秒的浮条:赶在「确认并解析」消失之前
Markdown 贴进去,新状况出现:正文上方浮出一个临时浮条,大意为"检测到 Markdown 内容",带两个按钮,其中一个是「确认并解析」。
这是知乎给手动粘贴设计的确认环节——毕竟有人贴一段纯文本只是想原样保留。问题在于这个浮条只在页面上停留很短一段时间,大约几百毫秒到一秒出头,超时自动消失。人看到再点都得手快,脚本更不能等:粘贴并填好标题之后睡 800 毫秒,然后在页面里搜出那个按钮、点下去。
await new Promise(r => setTimeout(r, 800));
const els = [...document.querySelectorAll('button,span,a,div')]
    .filter(e => e.textContent.trim() === '确认并解析' && e.children.length === 0);
els[els.length - 1].click();按钮一点,解析才真正发生:## 变成标题、表格变成表格、![]() 里的图片 URL 被依次抓取上传。图片转存是网络活,一篇带八张图的长文,得传十几秒。脚本的等法是轮询正文里的图片数量:每秒数一次,连续五次数字不变且图片数大于 0,才算上传完成(无图文章另走超时兜底)——而不是傻等一个拍脑袋的固定时长。
到这里,"注入"这条链路就通了。工具的 fill 命令把全过程串了起来:新开写文章页 → 探编辑器 → 合成 paste → 点浮条 → 等图传完。第一次端到端跑通时,命令行输出干脆利落:
编辑器探查: {"hasTitle":true,"hasBody":true}
正文注入结果: {"len":13535,"imgs":0}
确认并解析:{"found":true}
解析后正文图片数:8
六、★血案:删除按钮失灵,DELETE 全是 404
真正的硬仗在填完之后。
知乎有自动保存草稿的机制,而脚本每跑一次 fill 都新开一个写文章页——页面一打开就先生成一份空草稿,再加上注入过程中的多次自动保存,第一篇文章跑完,草稿箱里躺了三份标题相同的草稿。留一份完整的,另外两份得删掉。
叶扬点开草稿箱,点删除——什么都没发生。没有确认弹窗,没有网络抖动,草稿纹丝不动。
先怀疑权限:两种点击都失败
第一反应是事件不够"真"。脚本合成事件派出去的 .click(),isTrusted 属性是 false——页面理论上能区分"这是脚本点的"还是"这是人点的",有些站点的敏感操作只认真实点击。
那就上最重的手段:CDP 的 Input.dispatchMouseEvent,让浏览器在删除按钮的物理像素坐标上模拟鼠标按下、抬起。这种点击的 isTrusted 是 true,跟真人动鼠标没有任何区别。结果——还是没反应。
到这一步,"权限"这条怀疑路径基本走到头了。物理点击都删不掉,问题一定在别处。
网络面板抓现行:404
排查方向转向网络。给浏览器挂上网络监听,再点一次删除——请求确实发出去了,方法是 DELETE,而服务器的回应清清楚楚:
DELETE /api/articles/2087485493244179700/draft → 404 Not Found
404。浏览器请求删除的那个草稿,服务器说"不存在"。
可草稿明明就在列表里。再定睛一看 URL 里的 ID——...4179700。而草稿列表数据里,这份草稿的 ID 结尾并不是这个数。浏览器拿着一个错误的 ID 去删,服务器当然找不着。
ID 是怎么错的?草稿箱前端自己生成的删除链接,怎么会指向一个不存在的 ID?
根因:19 位 ID 撞上 2^53
把草稿 ID 抄出来看:2087485493244179789——十九位数字。
程序员对这个量级应该有点警觉了。JavaScript 里所有数字都是 IEEE 754 双精度浮点数,能精确表示的最大整数是:
Number.MAX_SAFE_INTEGER = 2^53 − 1 = 9007199254740991 (十六位)
而知乎草稿的新 ID 是十九位,远超 2^53。超过这条线之后,并不是"数字不能用了",而是精度开始一格一格地丢——相邻可表示的数字间距变成 256,落在格子之间的整数会被自动"吸"到最近的可表示值上。
草稿箱页面加载列表时,服务器返回的 JSON 里 ID 本来是精确的,但前端一 JSON.parse,ID 就变成了 JS Number,精度当场丢失。可以在 Node 里一行复现:
console.log(2087485493244179789);
// 输出:2087485493244179700
真实 ID 结尾是 ...79789,parse 一遍变成 ...79700——末三位被悄悄改写。
三种状态同屏对比,失真发生在 parse 那一瞬间:
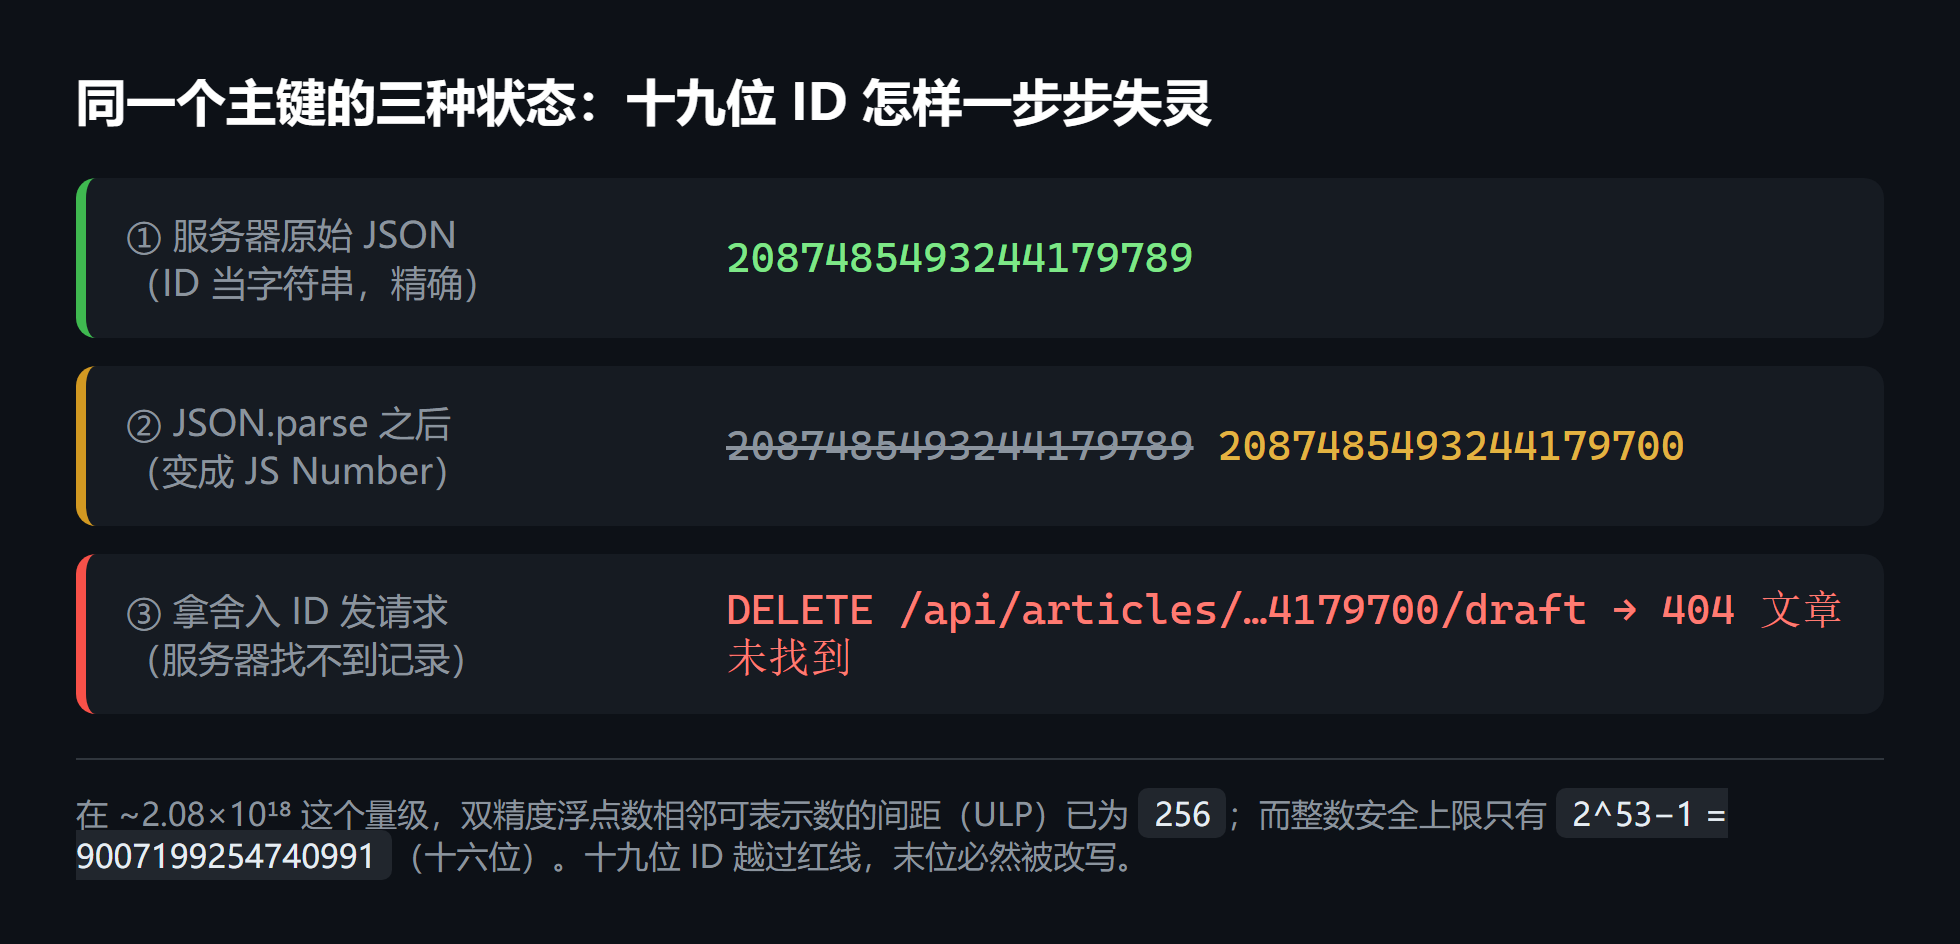 列表项上的删除、编辑链接全是用这个舍入后的 ID 拼出来的,请求打到服务器上,对应草稿不存在,404。
这就是"按钮点了没反应"的全部秘密:不是权限问题、不是风控、不是事件不够真,是前端用浮点数存了主键。这是一个工程史上反复上演的经典事故类型——用 float/double 存金额,账目对不上;用它存 ID,记录找不着。只不过这次事故发生在知乎自己的页面上,而"受害者"是想删草稿的叶扬。
顺带一提:旧的、ID 比较短的草稿(十位数)一切正常,这也解释了为什么这个 bug 能一直存在——老数据根本不触发。
绕行:禁 JSON.parse,从原始文本里正则提 ID
知道了根因,绕行方案也就明确了:绝不让长 ID 经过 Number 转换,全程当字符串处理。
脚本直接请求草稿箱列表 API,但不取 JSON——取原始响应文本,然后用正则表达式把 ID 一段段"抠"出来。正则匹配的结果天然是字符串,十九位数字一个字符都不会少:
const t = await (await fetch(
    '/api/articles/my_drafts?limit=10&offset=0',
    { credentials: 'include' })).text();        // 注意是 .text(),不是 .json()
// 每个草稿对象以 "content_length" 字段开头,按它切块
const marks = [...t.matchAll(/"content_length"\s*:\s*(\d+)/g)];
// seg = 两个相邻 content_length 锚点之间的文本块(示例取第一块)
const seg = t.slice(marks[0].index, marks[1] ? marks[1].index : t.length);
// 在块内正则提 ID —— 匹配结果是字符串,精度完好
const id = seg.match(/"id"\s*:\s*(\d+)/)[1];
这里还藏着一个实现细节:切块的锚点选的是 "content_length" 而不是 "id"。因为 ID 字段在每个草稿对象的后半部分,对象里还嵌套着带 id 的子结构,按 id 切块会把对象切乱;按每个对象开头的 content_length 切块,再在块内找 id,位置就准了。
拿到真实 ID,删除就是一句直白的 fetch:
const xsrf = document.cookie.match(/(?:^|;\s*)_xsrf=([^;]+)/)[1];
const r = await fetch(
    'https://zhuanlan.zhihu.com/api/articles/2087485493244179789/draft', {
        method: 'DELETE',
        headers: { 'x-xsrftoken': decodeURIComponent(xsrf) },
        credentials: 'include',
    });
// r.status === 200,删掉了
_xsrf 是知乎防跨站请求伪造的令牌,服务器用它确认"这个请求确实来自用户自己的页面",cookie 里就能读到。状态码 200,折腾了一整晚的重复草稿,应声而删。
七、分发适配三笔小账
除了编辑器本身,把博客稿改成知乎稿还有三笔适配账,都不大,但漏了就出洋相:
- 正文外链一律清走。博客正文里常带着 GitHub 的 issue/PR 链接(比如排查时引用上游报告),知乎版里这些链接全部转成纯文本(
charmbracelet/vhs#721直接当文字写),唯一的外链放在全文最后——「本文首发于个人独立博客」一句,指向原文; - 相对路径会变成知乎站内死链。博客里写的
/casts/vhs-demo.cast这类站内相对路径,知乎解析时会拼成zhuanlan.zhihu.com/casts/...,点过去 404。凡是平台上无法兑现的链接,改成文字说明——"这个交互终端播放器只在博客原文页面里有"; - Mermaid 提前转成 PNG。知乎不渲染 Mermaid,流程图在发文之前就要用无头浏览器渲染成图片、以
![]()的形式贴进去,由知乎转存图床。
验收口径也因此固定:每篇 fill 完,不看源稿,直接列出知乎编辑器里实际存在的全部 a[href]——源稿 grep 干净不代表编辑器里没多出东西(相对路径的变形就是贴进去才发生的)。
八、还没根治的毛刺:列表偶发返回空
工具并非全无毛刺。批量填稿时遇到过一次诡异现象:fill 流程里注入前快照显示"草稿数 0",注入完"本次新增草稿 []",仿佛整个列表 API 失效;但内容其实完好——换个正常标签重新一拉,新草稿安安静静躺在列表里。
判断是新开标签页的上下文里,带凭证的 fetch 存在时序问题(页面身份状态还没就绪),请求没拿到正常数据。目前的应对是流程上兜底:fill 结束后必须人工核对一次草稿箱份数与图片数,脚本输出只作参考。等后续批量分发跑得多了,再考虑加重试和校验把它彻底钉死——这种偶发问题,样本不够时不急着修,免得修错地方。
九、一个程序员类比:手动审批门,与用浮点数存主键
整条工作流的骨架,其实就是程序员熟悉的 CI/CD 审批门(manual approval gate):
脚本像 CI 流水线——拉代码、跑测试、打包构建产物、推到制品库,全自动,不知疲倦;但"部署到生产环境"这一步,流水线会停下来等人审批。点一下按钮,产物才上线。知乎这套流程一模一样:脚本负责到"构建产物(草稿)"为止,叶扬这个审批人过目之后,亲手点「发布」。
为什么非要留这道门?因为生产事故和知乎发文有同一个性质:自动化省下的时间,抵不上一次不可逆错误的代价。CI 不会因为"多此一举"就失去价值——它把除最后一步外的所有重复劳动都吃掉了;这个脚本也一样,前六篇文章就省下两小时,留给人的工作只剩审稿和点按钮。
而长 ID 那场血案,是另一个更古老的教训的浏览器版:永远不要用浮点数存标识符。数据库课上讲 DECIMAL 存金额、讲主键用整数或字符串,听着像陈旧常识;换个前端框架、换个 JSON 解析器,同一个坑照样有人掉进去——区别只在于这次掉进去的是知乎的页面,排查的人是叶扬。
十、吵架现场
「知乎又没有公开的发文 API,折腾这套旁门左道值得吗?」
值得,原因恰恰是没有公开 API。官方不给正门,分发需求又是真实存在的,剩下的选择只有两个:纯手工,或者走"人操作浏览器"这条正路——CDP 注入的每一步都对应真人的真实操作(粘贴、点解析、自动保存),没有伪造任何协议字段、没有绕过任何安全校验(_xsrf 令牌照带)。这不是攻击接口,是把人的手指自动化。
「手工发三篇也就一小时,写脚本倒花了一晚上。」
算账要算总账。脚本是一次性投入、可复用的资产:第一批三篇跑通,后面五十多篇就是一条命令加一次审稿的事;中途发现的长 ID bug、浮条时序、链接变形,全沉淀进了代码和这份记录。手工发七十篇,是二十多个小时的纯消耗,而且格式问题每篇重来一遍。
「就不怕账号被封?」
风险控制正是整个设计的起点,不是事后的补丁:脚本永不点发布、不带频率轰炸、严格串行(一篇做完、核实完再开下一篇)、登录走浏览器原生通道。知乎服务器能观察到的,是"有人慢慢存了几篇草稿、之后逐篇手动发布"——这是正常用户的样子,不是脚本大军。
术语表
| 术语 | 解释 |
|---|---|
| CDP(Chrome DevTools Protocol) | Chrome/Edge 的远程调试协议,HTTP 管标签页、WebSocket 发调试指令 |
| Draft.js | Meta 开源的富文本编辑器框架,内容存于 JS 状态而非 DOM,知乎正文用它 |
| contenteditable | HTML 属性,元素带它就能直接在页面上编辑,富文本编辑器的标准载体 |
| DataTransfer | 浏览器里承载拖拽/粘贴数据的对象,可放多种格式的内容 |
| 合成事件 | 用 JS 构造并派发的 DOM 事件;isTrusted=false,CDP 模拟的物理输入为 true |
| 2^53 / MAX_SAFE_INTEGER | JS 双精度浮点数能精确表示的整数上限(9007199254740991),超过即开始丢精度 |
| _xsrf | 防跨站请求伪造的令牌,知乎放在 cookie 里,写操作要回传给服务器 |
| 审批门 | CI/CD 中流水线暂停、等人工批准才继续部署的环节 |
收尾
三篇文章存进知乎草稿箱、叶扬逐篇过目、亲手发布之后,这套"只到草稿为止"的自动化就算真正立住了。
回头看,最费劲的没有一件是"写代码"本身:Draft.js 要靠粘贴喂、浮条只给八百毫秒、删除按钮的失灵一路追到 2^53——凡是页面行为和预期不符的时候,答案都在更下一层:先看 DOM,再看事件可信度,再看网络请求,最后看数据在传输中被什么规则改写过。这套排查顺序,比脚本本身更值钱。
下一批分发的素材已经在排队。脚本还是那条铁规矩:它什么都干,除了最后那一下。